La generazione video basata sull’intelligenza artificiale ha compiuto passi da gigante negli ultimi anni, ma uno degli ostacoli più persistenti è stato mantenere la coerenza dell’identità dei personaggi attraverso diverse scene e azioni. Molti modelli AI, pur eccellendo nella creazione di contenuti visivi, spesso falliscono nel preservare l’aspetto e il comportamento coerente di un personaggio, risultando in video poco realistici e frammentati.
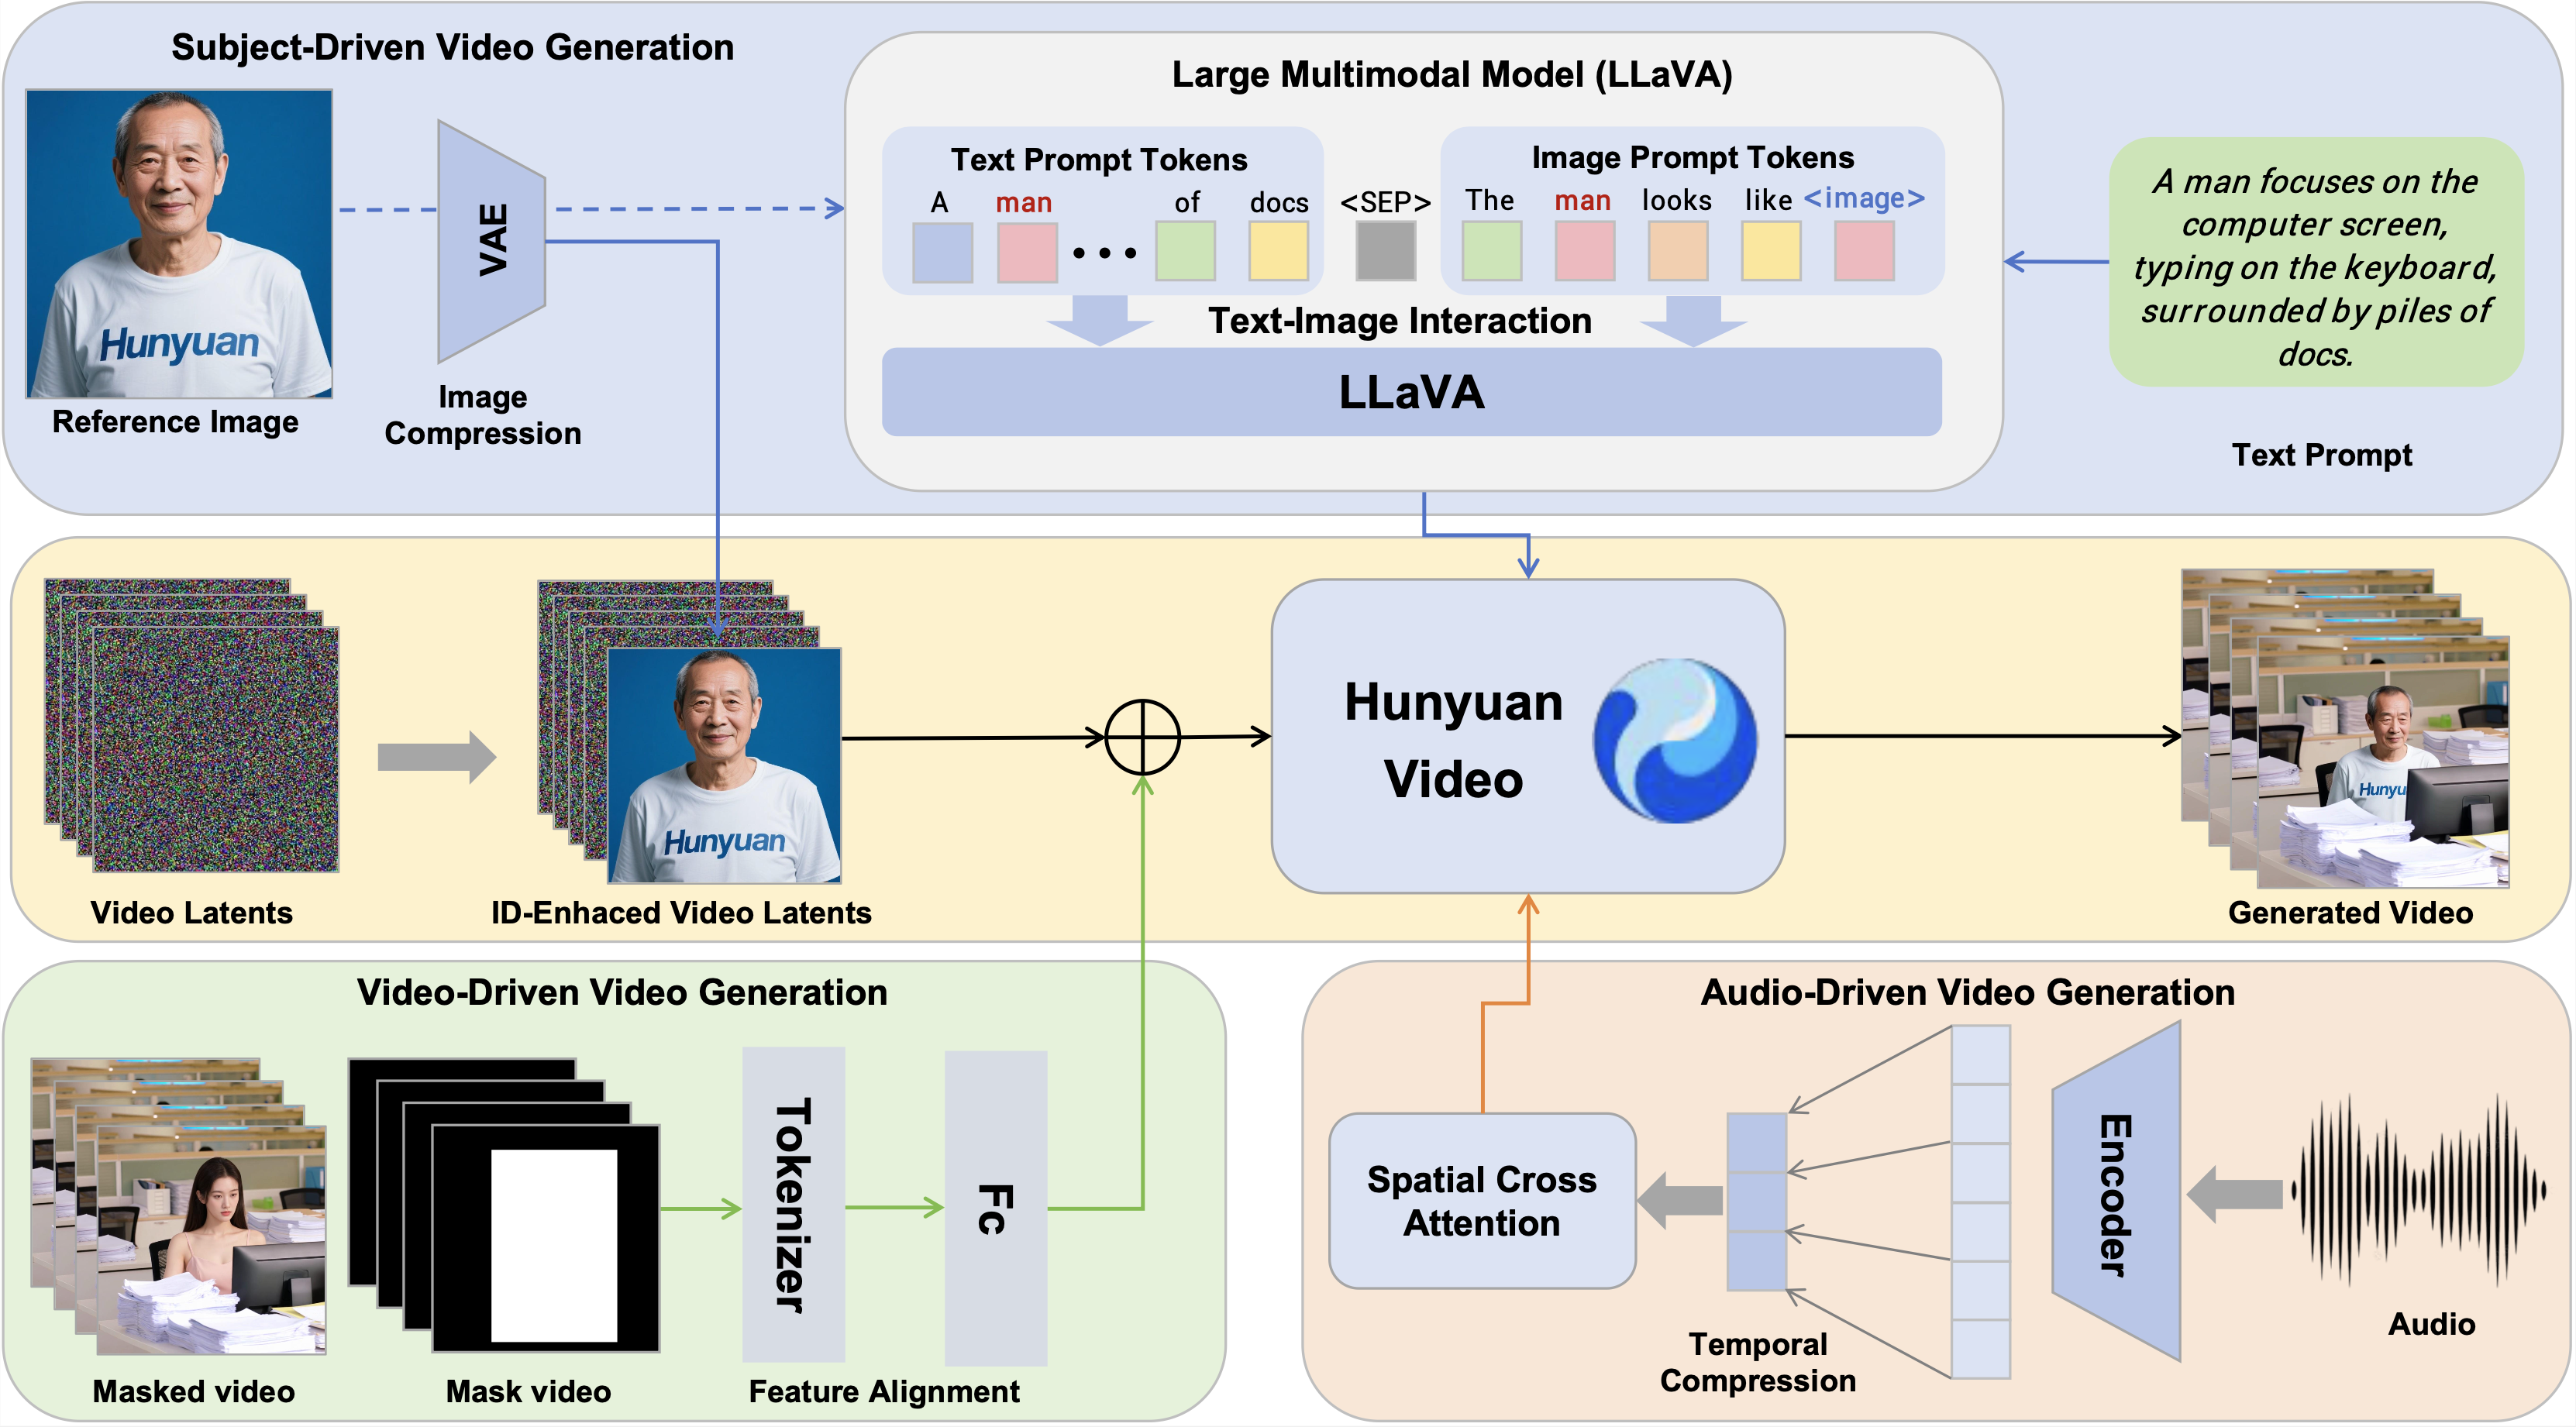
Tencent affronta direttamente questa sfida con il rilascio di HunyuanCustom, un modello AI open source progettato per generare video con personaggi coerenti, utilizzando input multimodali come testo, immagini, audio e video. Basato sul framework HunyuanVideo, HunyuanCustom introduce un’architettura avanzata che integra moduli di fusione immagine-testo e meccanismi di iniezione specifici per ogni modalità, garantendo che l’identità del soggetto rimanga costante durante l’intero video.
Una delle caratteristiche distintive di HunyuanCustom è la sua capacità di gestire input multipli per creare video realistici e coerenti. Ad esempio, è possibile fornire una singola immagine di un personaggio, una sceneggiatura e un clip audio, e il modello genererà un video in cui il personaggio parla e si muove in modo naturale, mantenendo l’aspetto e la voce coerenti. Questa capacità è particolarmente utile per applicazioni come pubblicità virtuali, avatar cantanti e video personalizzati.
HunyuanCustom supporta anche scenari più complessi con più personaggi. Utilizzando immagini di riferimento per ciascun soggetto e una descrizione testuale della scena, il modello può generare video in cui più personaggi interagiscono tra loro, mantenendo la coerenza dell’identità di ciascuno. Questa funzionalità apre nuove possibilità per la creazione di contenuti narrativi e interattivi, dove la coerenza dei personaggi è fondamentale.
Dal punto di vista tecnico, HunyuanCustom utilizza un modulo di fusione immagine-testo basato su LLaVA per facilitare l’interazione tra immagini e testo, consentendo l’integrazione efficace delle informazioni sull’identità nelle descrizioni testuali. Inoltre, un modulo di potenziamento dell’identità concatena le informazioni dell’immagine lungo l’asse temporale, sfruttando la capacità del modello video di modellare temporalmente per migliorare l’identità del soggetto durante il video.
Come testare HunyuanCustom:
Per coloro interessati a sperimentare con HunyuanCustom, il processo è relativamente semplice:
-
Requisiti di sistema: una macchina con almeno 16 GB di RAM e una GPU Nvidia è consigliata per prestazioni ottimali.
-
Clonare il repository: accedere al repository ufficiale su GitHub: https://github.com/Tencent/HunyuanCustom e clonarlo nel proprio ambiente locale.
-
Installare le dipendenze: utilizzare il comando
pip install -r requirements.txtper installare tutte le dipendenze necessarie. -
Caricare il modello: scaricare i pesi pre-addestrati disponibili su Hugging Face e caricarli nel proprio ambiente.
-
Eseguire l’inferenza: utilizzare gli script forniti per generare video basati su input di testo, immagini, audio o video.
Per coloro che preferiscono un approccio più semplice, è possibile utilizzare piattaforme cloud come Google Colab o Paperspace, dove sono disponibili notebook preconfigurati per eseguire HunyuanCustom senza la necessità di configurazioni complesse.
Il rilascio di HunyuanCustom rappresenta un passo significativo verso la democratizzazione della generazione video basata su AI. Offrendo un modello open source con capacità avanzate di mantenimento dell’identità, Tencent apre nuove possibilità per creatori di contenuti, sviluppatori e aziende di tutto il mondo. In un’epoca in cui la personalizzazione e la coerenza sono fondamentali, strumenti come HunyuanCustom potrebbero diventare indispensabili per la produzione di contenuti visivi di alta qualità.